单隐藏层神经网络——单样本情形#
学习目标与记号#
准确解释计算图、单隐藏层前向传播与链式法则;
根据公式和张量维度分析误差信号,并识别常见实现错误;
用
Python实现或验证梯度维度;在其他条件相同的情况下,只改变一个需要研究的因素进行比较,并根据实验结果分析该因素可能带来的影响。
本节沿用统一记号:普通小写字母表示标量,粗体小写字母表示向量,粗体大写字母表示矩阵或高阶张量;层编号写作上标 \([l]\),样本或时间编号写作下标;转置写作 \(\trans\)。除非另有说明,批量样本按行存放。正文与练习中的程序都应同时检查数值结果和数组维度。本节练习的参考答案见 单样本单隐藏层网络答案。
本节从 逻辑回归 推广到隐藏层网络。链式求导需要结合 激活函数及其导数,输出损失的概率解释可回看 逻辑回归与交叉熵。
本节先从一个样本 \((\bx,y)\) 出发,推导单隐藏层神经网络的前向传播与后向传播;下一节再将结果扩展到含 \(n\) 个样本的批量计算。记 \(\bx=(x_1,\ldots,x_d)\trans\in\mathbb{R}^d\) 和 \(y\in\{0,1\}\)。为便于展示,以下网络取 \(d=3\)、\(d^{[1]}=4\)、\(d^{[2]}=1\) 1输出层对应的是具有特征 \(\bx\) 的标签属于某一特定类别的概率。,因此共有 \(L=2\) 个含参数的层,其网络结构如 图 1 所示,输入层、隐藏层与输出层之间全连接。

图 1 只有一个隐藏层的全连接神经网络#
备注
在本课程中,我们通常用上角标表示神经元所在层,下角标表示对应神经元在该层的位置。例如,\(a_3^{[1]}\) 表示第一(隐藏)层中的第三个神经元,\(a_1^{[2]}\) 表示第二层中的第一个神经元。我们默认输入层为第 0 层,故 \(a_i^{[0]}=x_i\)。记 \(d^{[l]}\) 为第 \(l\) 层中神经元的总数,且记 \(d^{[0]}=d\)。 此外,与逻辑回归模型不同,神经网络通过隐藏层学习新的特征表示。例如,在 图 1 所示的模型中,第一层的四个神经元使用不同参数,从输入中提取四种信息,并把所得激活作为输出层的输入。输出层采用 sigmoid 函数作为激活函数,因而可以看作以隐藏层表示为特征的逻辑回归模型。
本节所涉及到的模型训练步骤为:
基于当前模型参数,前向传播计算神经网络各神经元的值以及对应的损失函数值。
后向传播,计算损失函数对当前参数的偏导数。
利用梯度下降法,依据当前学习率进行参数更新。
回到第 1 步,使用更新后的参数重新计算,直至满足预先设定的停止条件。
接下来,我们将依次对上述步骤进行剖析,并在本节的最后讨论如何对模型参数进行初始化。
前向传播#
首先,我们将具体讨论 图 1 中展示模型的前向传播计算过程。正如我们在 上一节 所讨论的那样,每个神经元包含线性变换和非线性变换(激活)两步运算,且不同神经元都对应着不同的偏置项和权重项。记 \(b_j^{[l]}\) 和 \(\bw_j^{[l]}\) 分别为神经元 \(a_j^{[l]}\) 所对应的(当前的)偏置项和权重项 2根据我们在 上一节 中所讨论的符号规则,第 \(t\) 步更新后的模型参数应该表达为 \(b_j^{[l](t)}\) 和 \(\bw_j^{[l](t)}\),但为了简化符号表达,本节省略表示迭代次数的上角标 \((t)\)。。
当神经网络的层数 \(l\) 为正整数时,为了计算神经元 \(a_j^{[l]}\) 在当前参数下的数值,我们通常将其上一层的结果 \(\{a_j^{[l-1]}:j=1,\ldots,d^{[l-1]}\}\) 作为该神经元的输入值。例如,对于 \(j=1,\ldots,d^{[1]}\),当我们计算 \(a_j^{[1]}\) 时,对应的输入特征为 \(\{a_j^{[0]}:j=1,\ldots,d^{[0]}\} =\{x_j:j=1,\ldots,d\}\)。此时,\(a_1^{[1]}\) 的计算过程为
更一般地,记 \(\ba^{[l]} = (a_1^{[l]},\ldots,a_{d^{[l]}}^{[l]})\trans\),则第 \(l\) 层的神经元 \(a_j^{[l]}\) 的计算规则如下:
这里用 \(g^{[l]}\) 表示第 \(l\) 层的激活函数。隐藏层可以选用 ReLU 和 tanh 等函数;二分类输出层通常使用 sigmoid 函数。不同层不必采用相同的激活函数。
通过以上计算可知,图 1 中模型的参数是每个神经元对应的偏置和权重:
需要指出的是,每个偏置项的维度均为 1,但对应于神经元 \(a_j^{[l]}\) 的权重项 \(\bw_j^{[l]}\) 的维度为 \(d^{[l-1]}\)。该神经网络前向传播的计算流程如下图所示。
为了提高模型的计算效率,我们需要对上述计算进行 向量化。对于神经网络的第 \(l\) 层,记 \(\bb^{[l]} = (b_1^{[l]},\ldots,b_{d^{[l]}}^{[l]})\trans\) 以及 \(\bW^{[l]}=[(\bw_1^{[l]})\trans;\ldots;(\bw_{d^{[l]}}^{[l]})\trans]\)。对于 \(l=1,\ldots,L\) 以及 \(j=1,\ldots,d^{[l]}\),\(\bb^{[l]}\) 和 \(\bW^{[l]}\) 中的第 \(j\) 行代表着第 \(l\) 层第 \(j\) 个神经元对应的偏置项和权重项。基于新定义的符号,我们可以得到 \(\ba^{[l]}\) 的向量化表达式 3对应于 \(\ba^{[l]}\),其输入特征为 \(\ba^{[l-1]}\)。
其中,对于向量 \(\bz=(z_1,\ldots,z_m)\trans\in\mathbb{R}^m\),定义 \(\sigma(\bz)=(\sigma(z_1),\ldots,\sigma(z_m))\trans\) 4对应于 Python 的 NumPy 包所涉及的 广播机制。,而 \(m\in\mathbb{N}\) 为任意正整数。
由于这里只考虑一个样本 \((\bx,y)\),图 1 中模型的向量化前向传播为
其中,\(a^{[2]}\) 是样本属于类别 1 的预测概率。对于单个样本,二元交叉熵损失为
以上计算结果对应的 计算图 如下图所示。
备注
前向传播的过程是基于当前参数计算神经网络各个神经元的结果。该过程有以下两个用途:
模型参数训练过程中,前向传播主要用于计算每个神经元在当前参数下的激活值,并计算相应的损失函数。前向传播为计算损失函数对参数的求导提供中间结果。
模型参数训练完毕后,前向传播用于计算并输出模型的估计结果。
后向传播#
当我们训练模型时,我们需要根据当前参数,计算损失函数对模型参数的偏导数,并利用梯度下降法对模型参数进行一步迭代更新。例如,对模型参数 \(\bb^{[1]}\) 的更新过程如下:
其中,\(\bb^{[1](t)}\) 是第 \(t\) 次更新前的第一层偏置向量,\(\alpha\) 是当前学习率 5学习率常随更新次数 \(t\) 增加而降低,但是否衰减以及如何衰减都属于需要验证的超参数选择。,\(\btheta^{(t)}\) 表示此时的全部模型参数。竖线记号强调梯度在同一组旧参数处计算。
与上一节的处理类似,为了简化符号,我们省略表示迭代次数的上角标 \((t)\)。本节主要分析二分类问题;对于回归或其他任务,需要相应更改输出层与损失函数。仍针对一个样本 \((\bx,y)\),考虑 图 1 所示的网络,其参数为 \(\btheta = \{\bb^{[1]},\bW^{[1]},b^{[2]},\bW^{[2]}\}\),损失函数参见式 (18)。这里输出层宽度为 1,所以 \(b^{[2]}\) 是标量,\(\bW^{[2]}\in\mathbb{R}^{1\times d^{[1]}}\) 是行向量。
偏导数的维度与记号#
后向传播的数学基础是链式法则。为避免标量、向量和矩阵求导时混淆转置,先统一记号:以下用 \(\bu\in\mathbb{R}^{m\times1}\) 表示一般列向量,用 \(f\) 表示标量函数;网络的输入仍记为 \(\bx\),损失仍记为 \(\mathcal{J}\)。标量函数对某个变量的梯度,与该变量具有相同形状。
对向量函数 \(\bh(\bu)=(h_1(\bu),\ldots,h_k(\bu))\trans\),本课程把各分量的列梯度并排排列,定义
因此,行对应输入分量,列对应输出分量。通常用于线性近似的雅可比矩阵(Jacobian)则为 \(D_{\bh}(\bu)\trans\in\mathbb{R}^{k\times m}\),即 \(\bh(\bu+\bepsilon)\approx\bh(\bu)+D_{\bh}(\bu)\trans\bepsilon\)。两种排列互为转置,并不矛盾;本节始终采用上面的记号,不能在同一推导中混用排列约定。
常见函数的求导#
若 \(\bc\in\mathbb{R}^{m\times1}\) 为常向量,则 \(f(\bu)=\bc\trans\bu=\sum_i c_i u_i\) 的梯度为 \(\bc\)。若 \(\bu,\bv\) 是两个独立变量,则内积对二者分别求导为
但如果内积的两项都依赖同一个变量,就必须使用乘积法则。设 \(\bp(\bu),\bq(\bu)\in\mathbb{R}^{k\times1}\),则
恒等映射与线性映射是后向传播中最常见的局部运算。若 \(\bh(\bu)=\bA\bu+\bc\),其中 \(\bA\in\mathbb{R}^{k\times m}\)、\(\bc\in\mathbb{R}^{k\times1}\) 为常量,则逐项求导可得
为说明转置出现的原因,我们将课件中的线性映射例子按本节符号展开。记 \(\br_j\trans\) 为 \(\bA\) 的第 \(j\) 行,则 \(h_j(\bu)=\br_j\trans\bu+c_j\)。由常向量内积的求导结果,\(\partial h_j/\partial\bu=\br_j\),因而
这说明,转置不是为凑齐维度而添加的符号,而是把每个输出分量的列梯度并排排列得到的结果。取 \(\bA=\bI_m\)、\(\bc=\boldsymbol{0}\),就得到课件中的恒等映射例子。
作为乘积法则的例子,取常矩阵 \(\bA\in\mathbb{R}^{m\times m}\),对二次型求导有
具体地,按照课件中的分解方法,令 \(\bp(\bu)=\bu\)、\(\bq(\bu)=\bA\bu\),则 \(f(\bu)=\bp(\bu)\trans\bq(\bu)\)。将恒等映射和线性映射的导数代入乘积法则,得到
只有在 \(\bA\) 对称时,才能简化为 \(2\bA\bu\);特别地,\(\partial(\bu\trans\bu)/\partial\bu=2\bu\)。不能把依赖 \(\bu\) 的另一项误当作常量而漏掉一项导数。
链式法则:沿路径相乘,对路径求和#
对标量复合函数 \(f(x)=g(h(x))\),若各函数在相应点可导,则 \(f'(x)=g'(h(x))h'(x)\)。这里 \(g'\) 必须在中间值 \(h(x)\) 处计算,而不是在 \(x\) 处计算。为与下图一致,这里用 \(x\) 表示标量自变量,与网络的列向量输入 \(\bx\) 相区别。
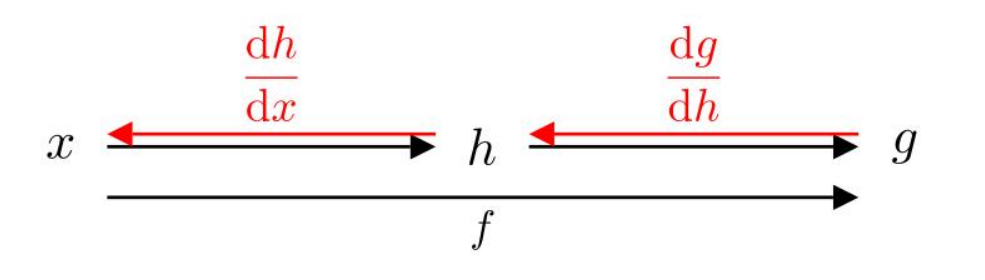
图 2 单路径复合函数的计算图:沿同一条路径将局部导数相乘。#
图中黑色箭头表示从自变量到输出的计算过程,红色箭头表示求导时沿相反方向传递的局部导数。节点 \(h\) 和 \(g\) 分别表示中间值 \(h(x)\) 和输出 \(g(h(x))\),下方的 \(f\) 表示整个复合映射,而不是另一条需要相加的计算路径。因此,我们有
进一步,我们考虑课件中的双路径情形。若 \(\bh(x)=(h_1(x),h_2(x))\trans\),且 \(f(x)=g(h_1(x),h_2(x))\),则 \(x\) 可以分别通过 \(h_1\) 与 \(h_2\) 影响输出。因此,计算总导数时,需要把两条路径的贡献相加。
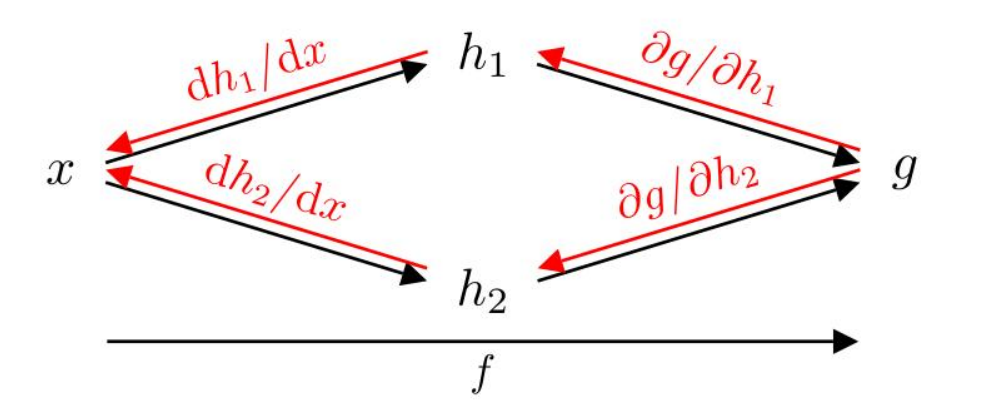
图 3 双路径复合函数的计算图:分别沿两条路径求导,再将结果相加。#
其中,\(\partial g/\partial h_1\) 表示暂时固定 \(h_2\) 后对 \(h_1\) 求偏导,\(\partial g/\partial h_2\) 的含义类似。例如,令 \(h_1(x)=x^2\)、\(h_2(x)=3x\),且 \(g(h_1,h_2)=h_1h_2\),则 \(f'(x)=h_2(2x)+h_1(3)=9x^2\),与直接对 \(f(x)=3x^3\) 求导一致。只考虑其中一条路径就会漏项。
类似地,当标量 \(x\) 通过 \(k\) 个中间变量影响输出,即 \(f(x)=g(h_1(x),\ldots,h_k(x))\) 时,我们有
推广到列向量输入,设 \(\bh:\mathbb{R}^m\to\mathbb{R}^k\)、\(g:\mathbb{R}^k\to\mathbb{R}\),且 \(f=g\circ\bh\),则分量求和可写成矩阵乘法:
所有局部导数均在当前输入及其中间值处计算。若自变量是矩阵 \(\bW\),仍可使用 \(\partial f/\partial\bW=\sum_j(\partial h_j/\partial\bW)(\partial g/\partial h_j)\),逐项相加得到与 \(\bW\) 同形的矩阵;不必构造高阶导数张量,也不能未经形状检查就套用列向量的矩阵乘法公式。
应用到网络:从输出层向隐藏层传播#
首先,我们以求解 \(\partial \mathcal{J}/\partial b^{[2]}\) 为例探讨后向传播的基本原理。根据 前向传播的计算图,基于参数 \(b^{[2]}\) 的计算结果为 \(z^{[2]}\)。因此,我们可将中间变量 \(z^{[2]}\) 视为参数 \(b^{[2]}\) 的函数,而损失函数 \(\mathcal{J}\) 可以被视为中间变量 \(z^{[2]}\) 的函数。为了求解损失函数对参数 \(b^{[2]}\) 的导数,我们可将损失函数 \(\mathcal{J}(\btheta)\) 视为复合函数形式 \(\mathcal{J}\circ z^{[2]}\),其中自变量为 \(b^{[2]}\)。则根据链式法则,我们有如下计算结果
根据式 (17) 计算结果可知,
进一步根据链式法则,我们可知
式 (20) 中所涉及的两个偏导数也可根据式 (17) 计算结果求得,即
类似地,我们可以求出损失函数对于其他三个参数的偏导数。
备注
上述推导说明:参数梯度可以沿计算图拆成若干局部导数,并复用前向传播在式 (17) 中计算的中间量。这正是后向传播能够高效实现链式法则的原因。
用误差信号组织后向传播
将第 \(l\) 层线性输入的梯度记为 \(\bdelta^{[l]}=\partial\mathcal{J}/\partial\bz^{[l]}\)。 对使用 sigmoid 函数的输出层与二元交叉熵的组合,两个导数恰好相消,因此
隐藏层误差信号由后一层向前传播:
其中 \(\odot\) 表示逐元素乘法。若隐藏层也使用 sigmoid 函数,则 \(g^{[1]\prime}(\bz^{[1]})=\ba^{[1]}\odot(1-\ba^{[1]})\)。 这种“先求每层误差信号,再求参数梯度”的写法更容易推广到深层网络。
上面的隐藏层公式可以直接由局部导数得到。因为 \(z^{[2]}=b^{[2]}+\bW^{[2]}\ba^{[1]}\) 是标量,而 \(\ba^{[1]}\) 是列向量,所以
隐藏层激活逐元素作用,因此其导数矩阵为对角矩阵;将它乘以上游传来的梯度,就得到前面的逐元素乘法形式:
最后,令 \(\be_j\) 为 \(\mathbb{R}^{d^{[1]}}\) 中第 \(j\) 个标准基列向量。由 \(z_j^{[1]}=b_j^{[1]}+\sum_{i=1}^{d}W_{ji}^{[1]}x_i\),有 \(\partial z_j^{[1]}/\partial\bW^{[1]}=\be_j\bx\trans\)。对所有中间分量求和,就得到隐藏层权重的外积梯度:
同时,\(\partial(\bz^{[1]})\trans/\partial\bb^{[1]}=\bI_{d^{[1]}}\),而 \(\partial z^{[2]}/\partial\bW^{[2]}=(\ba^{[1]})\trans\)。这解释了偏置梯度为何等于对应层的误差信号,以及权重梯度为何包含输入的转置。这里 \(\bI\) 表示单位矩阵;以上计算仅使用局部导数,无需展开整个损失函数。
经过代数运算,我们可得到如下梯度结果:
这四个梯度分别与 \(b^{[2]}\)、\(\bW^{[2]}\)、 \(\bb^{[1]}\) 和 \(\bW^{[1]}\) 同形。检查梯度与参数的维度是否一致,是发现后向传播实现错误的有效方法。
备注
后向传播会复用前向传播的中间量。对于本例使用 sigmoid 函数得到的激活值,缓存 \(\bx\)、\(\ba^{[1]}\) 和 \(a^{[2]}\) 已足够;在一般实现中通常缓存 \(\bz^{[l]}\) 与 \(\ba^{[l]}\),因为不少激活函数的导数需要线性输入 \(\bz^{[l]}\)。
后向传播以及梯度计算的总结如下图所示。
记 \(\btheta^{(t)}\) 为第 \(t\) 次更新前的全部参数。梯度下降对每个参数执行相同形式的更新:
其中,\(\btheta^{(t)}=\{\bb^{[1](t)},\bW^{[1](t)},b^{[2](t)},\bW^{[2](t)}\}\),且同一次更新中的所有梯度都应在同一组旧参数 \(\btheta^{(t)}\) 处计算。
再看后向传播#
后向传播可以看作重复应用同一个局部规则:先把后一层的误差信号传回当前层,再由当前层的输入计算参数梯度。下面分别展示隐藏层与输出层的依赖关系。
输出层
核心推导与实现核验#
核心关系
推导路径。 输出误差先经下一层权重的转置传播到隐藏激活,再乘隐藏激活对线性输入的逐元素导数;外积 \(\bdelta^{[1]}\cdot\bx\trans\) 产生与第一层权重同形的梯度。
关键条件
由微分 \(\mathrm d\bz^{[1]}=\mathrm d\bW^{[1]}\cdot\bx\) 和迹运算,可验证权重梯度必为误差信号与输入的外积,而不是相反次序。
数据规模
若每个样本有 \(d\) 个输入特征,隐藏层有 \(d^{[1]}\) 个神经元,则第一层权重 \(\bW^{[1]}\) 有 \(d^{[1]}\) 行和 \(d\) 列,隐藏层误差 \(\bdelta^{[1]}\) 有 \(d^{[1]}\) 个数。外积 \(\bdelta^{[1]}\cdot\bx\trans\) 的大小恰好与 \(\bW^{[1]}\) 相同。
常见误区
后向传播中使用已经更新过的权重会混合两个参数时刻;转置方向写错则常以维度不匹配或错误广播出现。
动手检查
在 float64 小网络上逐参数做 中心差分,要求相对误差通常低于 1e-6;再比较逐样本梯度之和与批量矩阵梯度。
数值稳定性与规模
二分类损失根据输出层的线性运算结果计算,初始化按 fan-in 缩放;每层记录激活和梯度范数。出现梯度爆炸时先检查公式与学习率,再考虑全局范数裁剪。
本节小结#
后向传播是计算图上链式法则的复用。
误差信号与输入外积给出权重梯度。
同形检查和 数值梯度检验 是两道重要防线。
综合练习#
练习重点是把本节的前向传播与后向传播公式落实为可核验的计算和程序,并通过公平的实验比较模型的预测性能与计算效率。程序题应固定数据划分、随机种子集合和训练预算,写出维度断言并报告运行环境。全部参考答案见 单样本单隐藏层网络答案。
前向传播与后向传播。 对单个二分类样本 \((\bx,y)\),从式 (17) 与式 (18) 出发,推导 \(\delta^{[2]}\)、\(\bdelta^{[1]}\) 以及损失函数关于 \(\bW^{[2]}\)、\(b^{[2]}\)、\(\bW^{[1]}\) 和 \(\bb^{[1]}\) 的梯度。逐项写明维度,并说明为什么同一次参数更新必须使用同一组旧参数计算全部梯度。
外积形式的证明。 使用矩阵微分或分量求导证明 \(\partial\mathcal{J}/\partial\bW^{[1]}=\bdelta^{[1]}\cdot\bx\trans\)。说明外积次序不能交换的原因,并验证所得梯度与 \(\bW^{[1]}\) 同形。
具体数值计算。 令 \(\bx=(1,-1)\trans\)、\(y=1\)、\(\bW^{[1]}=\bI_2\)、\(\bb^{[1]}=\boldsymbol 0\)、\(\bW^{[2]}=(1,-1)\)、\(b^{[2]}=0\),两层均使用 sigmoid 函数。手算 \(\bz^{[1]}\)、\(\ba^{[1]}\)、\(z^{[2]}\)、\(a^{[2]}\)、\(\mathcal{J}\)、两层误差信号和四组参数梯度,并用程序复核每个中间结果。
线性激活与逻辑回归。 假设隐藏层采用线性激活 \(g^{[1]}(z)=z\),输出层仍采用 sigmoid 函数。证明该网络的预测概率可以写成逻辑回归的形式,并给出等价的回归系数与截距。进一步说明“预测函数等价”为什么不意味着两种参数化具有相同的优化问题。
单样本程序实现。 仅使用
NumPy编写forward_backward函数,完成单样本的前向传播与后向传播。程序应检查参数和中间量的维度,使用输出层线性运算结果稳定地计算二元交叉熵,并返回损失、预测概率、缓存和全部梯度。使用第 3 题的数据核验实现。有限差分核验。 将第 5 题中的全部参数依次展平成一个向量,使用 中心差分 逐参数核验解析梯度。分别报告最大绝对误差和相对误差,讨论差分步长过大或过小时误差增大的原因,并设置明确的通过标准。
批量训练与测试。 将单样本实现扩展为按行存放样本的批量版本,使用批量梯度下降训练二分类模型。编写测试比较逐样本梯度的平均值与批量梯度,并检查损失是否在一个可控的小数据集上下降;再实现
predict_proba和predict,说明如何避免训练集信息进入验证集或测试集。逻辑回归与单隐藏层网络。 分别生成一个近似线性可分数据集和一个具有非线性边界的二分类数据集,比较逻辑回归与单隐藏层神经网络。固定训练集、验证集和测试集的划分、随机种子集合以及训练预算;仅使用验证集选择超参数,方案确定后再评价测试集。报告准确率、AUC、对数损失、训练时间、固定批量的预测时间、参数量和峰值内存,并解释两个数据集上差异产生的原因。
隐藏神经元个数。 在同一非线性二分类数据集上,将隐藏神经元个数依次设为 \(2,4,8,16,32\)。保持数据划分、随机种子集合、优化方法、学习率和训练预算一致,比较训练集、验证集与测试集上的预测指标以及训练时间、固定批量预测时间、参数量和峰值内存。画出指标随隐藏神经元个数变化的曲线,并讨论欠拟合、模型容量与过拟合之间的关系。
学习率与初始化尺度。 对学习率和第一层权重的初始化尺度进行二维对照实验。除这两个因素外,固定数据划分、随机种子集合、隐藏神经元个数和训练预算;记录损失曲线、最终参数范数、梯度范数、准确率、AUC、对数损失、训练时间、固定批量预测时间和峰值内存。分析学习率过大或过小以及初始化尺度过大或过小时的表现,并说明结论适用的数据范围与训练预算。